TensorFlow Production Environment
As a leading machine learning framework in the industry, TensorFlow requires consideration of many factors when migrating from an experimental environment to a production environment.
This article will comprehensively introduce the key considerations for TensorFlow in a production environment, helping developers build stable and efficient machine learning systems.
1. Model Optimization
1.1 Model Quantization
Example
# Post-training quantization example
import tensorflow as tf
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
import tensorflow as tf
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
- 8-bit integer quantization: Reduces model size by 75%, improves inference speed by 3-4 times
- 16-bit floating-point quantization: Performance improvement on GPU, minimal accuracy loss
- Dynamic range quantization: Only quantizes weights, activations remain floating-point during inference
1.2 Model Pruning
Example
# Pruning using the TensorFlow Model Optimization Toolkit
pruning_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=end_step)
}
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(
original_model, **pruning_params)
pruning_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=end_step)
}
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(
original_model, **pruning_params)
- Removes neuron connections that have little impact on output
- Typically reduces parameters by 60% without significantly affecting accuracy
- Requires fine-tuning to recover some accuracy loss
1.3 Model Distillation
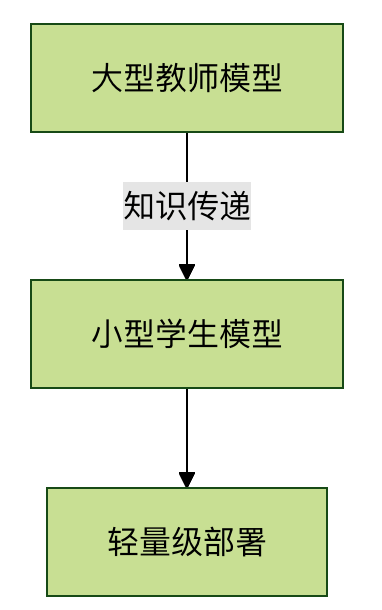
- Uses a large model to guide the training of a small model
- Maintains over 90% accuracy while reducing parameter count by 90%
- Especially suitable for edge device deployment scenarios
2. Deployment Architecture
2.1 Service Mode Comparison
| Deployment Method | Latency | Throughput | Resource Usage | Applicable Scenarios |
|---|---|---|---|---|
| TensorFlow Serving | Medium | High | Medium | Cloud services, high concurrency |
| TFLite | Low | Medium | Low | Mobile/IoT devices |
| ONNX Runtime | Medium | High | Medium | Unified deployment across multiple frameworks |
| Custom gRPC service | Adjustable | Adjustable | Adjustable | Special requirement scenarios |
2.2 Microservices Architecture
Example
# Simple model service built with Flask
from flask import Flask, request
import tensorflow as tf
app = Flask(__name__)
model = tf.keras.models.load_model('path/to/model')
@app.route('/predict', methods=['POST'])
def predict():
data = request.json['data']
prediction = model.predict(data)
return {'prediction': prediction.tolist()}
from flask import Flask, request
import tensorflow as tf
app = Flask(__name__)
model = tf.keras.models.load_model('path/to/model')
@app.route('/predict', methods=['POST'])
def predict():
data = request.json['data']
prediction = model.predict(data)
return {'prediction': prediction.tolist()}
- Containerization: It is recommended to use Docker to package the model and environment
- Service discovery: Combined with Kubernetes for automatic scaling
- Monitoring integration: Prometheus + Grafana monitoring system
3. Performance Optimization
3.1 Hardware Acceleration
GPU optimization techniques:
- Use
tf.config.optimizer.set_jit(True)Enable XLA compilation - Batch process input data (typical batch size 32-256)
- Use mixed-precision training (
tf.keras.mixed_precision)
TPU configuration:
Example
resolver = tf.distribute.cluster_resolver.TPUClusterResolver()
tf.config.experimental_connect_to_cluster(resolver)
tf.tpu.experimental.initialize_tpu_system(resolver)
strategy = tf.distribute.TPUStrategy(resolver)
tf.config.experimental_connect_to_cluster(resolver)
tf.tpu.experimental.initialize_tpu_system(resolver)
strategy = tf.distribute.TPUStrategy(resolver)
3.2 Graph Optimization
Example
# Session configuration optimization
config = tf.compat.v1.ConfigProto()
config.graph_options.optimizer_options.global_jit_level = tf.compat.v1.OptimizerOptions.ON_1
config.gpu_options.allow_growth = True
session = tf.compat.v1.Session(config=config)
config = tf.compat.v1.ConfigProto()
config.graph_options.optimizer_options.global_jit_level = tf.compat.v1.OptimizerOptions.ON_1
config.gpu_options.allow_growth = True
session = tf.compat.v1.Session(config=config)
- Constant folding
- Operation fusion
- Dead code elimination
- Memory optimization
4. Monitoring and Maintenance
4.1 Key Monitoring Metrics
System metrics:
- GPU/CPU utilization
- Memory usage
- Request latency (P50/P90/P99)
Model metrics:
- Prediction confidence distribution
- Input data distribution drift
- Model decay metrics
4.2 A/B Testing Framework
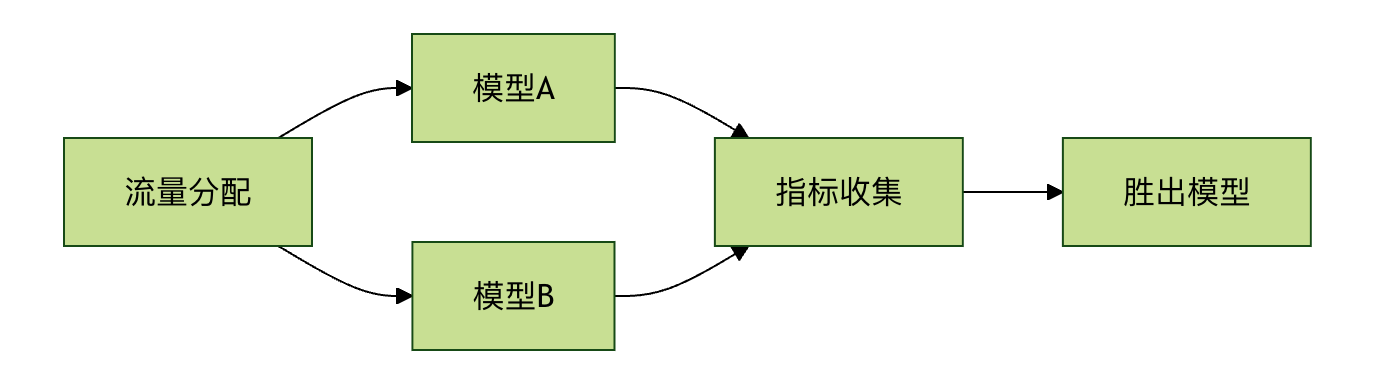
- Gradual traffic switching (5% → 50% → 100%)
- Multi-dimensional metric comparison (business metrics + technical metrics)
- Automatic rollback mechanism
5. Security Considerations
5.1 Model Protection
- Use
tf.saved_model.saveEncrypted models - Implement model watermarking technology
- Regularly rotate deployment keys
5.2 Input Validation
Example
# Input data validation example
def validate_input(input_data):
if not isinstance(input_data, np.ndarray):
raise ValueError("Input must be numpy array")
if input_data.shape != EXPECTED_SHAPE:
raise ValueError(f"Shape must be {EXPECTED_SHAPE}")
if np.isnan(input_data).any():
raise ValueError("Input contains NaN values")
def validate_input(input_data):
if not isinstance(input_data, np.ndarray):
raise ValueError("Input must be numpy array")
if input_data.shape != EXPECTED_SHAPE:
raise ValueError(f"Shape must be {EXPECTED_SHAPE}")
if np.isnan(input_data).any():
raise ValueError("Input contains NaN values")
- Data type checking
- Numerical range validation
- Abnormal input filtering
6. Continuous Integration and Delivery
6.1 ML Pipeline Design
Example
# Simple pipeline built with TFX
from tfx.components import Trainer
from tfx.proto import trainer_pb2
trainer = Trainer(
module_file=module_file,
transformed_examples=transform.outputs['transformed_examples'],
schema=infer_schema.outputs['schema'],
train_args=trainer_pb2.TrainArgs(num_steps=10000),
eval_args=trainer_pb2.EvalArgs(num_steps=5000))
- Automated model training
- Automated model evaluation
- Automated model deployment
6.2 Version Control Strategy
- Model version bound to code version
- Data snapshot preservation
- Complete experiment records