NLP Text Similarity Calculation
Text similarity calculation is a fundamental task in Natural Language Processing (NLP), aimed at quantifying the degree of similarity between two text segments. This technology is widely used in various fields such as information retrieval, question answering systems, plagiarism detection, and recommendation systems.
Core Concepts
- Semantic Similarity: Measures how close texts are in meaning
- Literal Similarity: Measures the degree of overlap in surface vocabulary of texts
- Vector Space Model: Represents texts as vectors in a high-dimensional space
- Distance Metrics: Computes the distance or similarity between vectors
Common Text Similarity Calculation Methods
1. Word Frequency-Based Methods
Bag of Words Model
Example
from sklearn.feature_extraction.text import CountVectorizer
corpus = [
'I like natural language processing',
'I love learning NLP technology',
'Text similarity calculation is very interesting'
]
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(corpus)
print(X.toarray())
corpus = [
'I like natural language processing',
'I love learning NLP technology',
'Text similarity calculation is very interesting'
]
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(corpus)
print(X.toarray())
TF-IDF Method
Example
from sklearn.feature_extraction.text import TfidfVectorizer
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(corpus)
print(tfidf_matrix.toarray())
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(corpus)
print(tfidf_matrix.toarray())
2. Word Vector-Based Methods
Word2Vec Similarity
Example
from gensim.models import Word2Vec
sentences = [
['I','like','natural language processing'],
['I','love','learning','NLP','technology'],
['text','similarity','calculation','very','interesting']
]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1, workers=4)
vector = model.wv['natural language processing'] # Get word vectors
Sentence Vector Calculation
Example
import numpy as np
def sentence_vector(sentence, model):
vectors = [model.wv[word] for word in sentence if word in model.wv]
return np.mean(vectors, axis=0) if vectors else np.zeros(model.vector_size)
sentence_vec1 = sentence_vector(['I','like','natural language processing'], model)
sentence_vec2 = sentence_vector(['I','love','NLP'], model)
3. Pre-trained Model-Based Methods
BERT Similarity Calculation
Example
from transformers import BertTokenizer, BertModel
import torch
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("This is an example sentence", return_tensors="pt")
outputs = model(**inputs)
last_hidden_states = outputs.last_hidden_state
import torch
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("This is an example sentence", return_tensors="pt")
outputs = model(**inputs)
last_hidden_states = outputs.last_hidden_state
Similarity Metrics
Common Distance Metrics
| Method Name | Formula | Characteristics |
|---|---|---|
| Cosine Similarity | cos(θ) = (A·B)/(|A||B|) | Ignores vector length, focuses on direction |
| Euclidean Distance | √Σ(Ai-Bi)² | Considers the absolute position of vectors |
| Manhattan Distance | Σ|Ai-Bi| | Not sensitive to outliers |
| Jaccard Similarity | |A∩B|/|A∪B| | Suitable for set similarity |
Code Implementation Examples
Example
from sklearn.metrics.pairwise import cosine_similarity
# Calculate cosine similarity
similarity = cosine_similarity(tfidf_matrix[0:1], tfidf_matrix[1:2])
print(f"Text similarity: {similarity)
# Calculate cosine similarity
similarity = cosine_similarity(tfidf_matrix[0:1], tfidf_matrix[1:2])
print(f"Text similarity: {similarity)
Practical Application Examples
News Headline Similarity Detection
Example
import pandas as pd
from sklearn.metrics.pairwise import cosine_similarity
# Example data
titles = [
"Apple releases new iPhone",
"Apple Inc. launches the latest smartphone",
"Microsoft announces quarterly earnings report",
"Google announces new artificial intelligence plan"
]
# Calculate similarity matrix
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(titles)
similarities = cosine_similarity(tfidf_matrix)
# Display results
df = pd.DataFrame(similarities, columns=titles, index=titles)
print(df)
Result Analysis
                         苹果发布新款iPhone手机  苹果公司推出最新智能手机  微软公布季度财报  谷歌宣布新的人工智能计划
苹果发布新款iPhone手机           1.000000         0.723417     0.000000         0.000000
苹果公司推出最新智能手机         0.723417         1.000000     0.000000         0.000000
微软公布季度财报               0.000000         0.000000     1.000000         0.204598
谷歌宣布新的人工智能计划         0.000000         0.000000     0.204598         1.000000
Advanced Techniques and Challenges
1. Handling Texts with Similar Semantics but Different Vocabulary
Example
text1 = "I like cats"
text2 = "I hate dogs"
# Surface similarity is low, but both semantically express attitudes toward animals
text2 = "I hate dogs"
# Surface similarity is low, but both semantically express attitudes toward animals
2. Solving the Polysemy Problem
Example
# "Apple" can refer to a fruit or a company
text1 = "The apple is very sweet"
text2 = "Apple's market value hits a new high"
text1 = "The apple is very sweet"
text2 = "Apple's market value hits a new high"
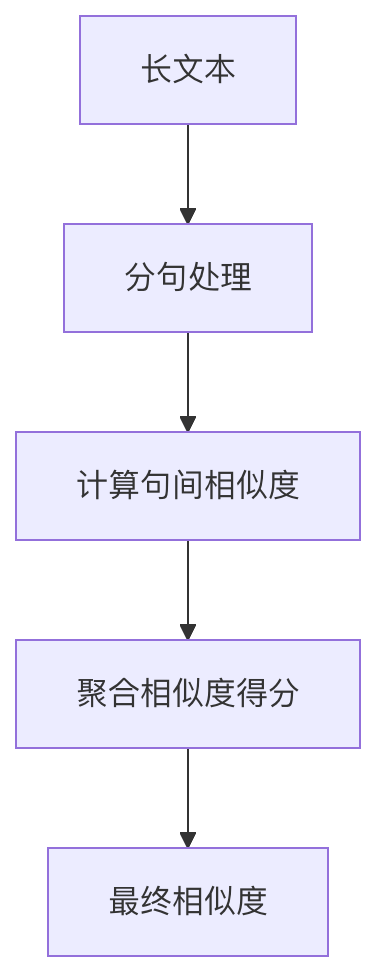
3. Long Text Similarity Calculation
Best Practice Recommendations
Data preprocessing is important
- Normalize case
- Remove stop words
- Stemming / Lemmatization
Choose methods based on the scenario
- Short texts: pre-trained models such as BERT
- Long documents: TF-IDF + cosine similarity
- Real-time systems: lightweight models such as Word2Vec
Consider computational efficiency
- Use Approximate Nearest Neighbor (ANN) algorithms for large-scale data
- Consider using efficient similarity search libraries such as Faiss
Continuous evaluation and optimization
- Build a manual evaluation set
- Monitor performance in production environments
- Regularly update models